Web scraping a etyka i prawo – co wolno, a czego nie przy automatycznym pobieraniu danych?
Odpowiedź na skróty (BLUF): Samo pobieranie publicznie dostępnych danych nie jest zakazane, ale granice wyznaczają prawo autorskie, ochrona baz danych, RODO oraz regulamin serwisu. Bezpieczna praktyka to respektowanie robots.txt, limitowanie zapytań i pobieranie wyłącznie tego, co faktycznie potrzebne.
Spis Treści
Ten tekst opisuje praktyki techniczne i typowe ryzyka. Nie jest poradą prawną – ocena konkretnego przypadku, zwłaszcza przy danych osobowych i bazach danych, wymaga konsultacji z prawnikiem.
Automatyczne pobieranie danych ze stron internetowych bywa przedstawiane skrajnie: jako zwykłe czytanie tego, co i tak jest publiczne, albo jako działanie z pogranicza prawa. Rzeczywistość mieści się pomiędzy, a różnicę robi to, co dokładnie się pobiera, w jaki sposób i do czego następnie wykorzystuje.
Skąd biorą się wątpliwości prawne
Przeglądarka też pobiera treść strony – różnica polega na skali i automatyzacji. Kiedy skrypt odpytuje serwis tysiące razy na godzinę, przestaje być czytelnikiem, a staje się obciążeniem dla infrastruktury. Kiedy kopiuje całe zbiory danych i buduje z nich konkurencyjną usługę, wchodzi w obszar chroniony przepisami o bazach danych. Dlatego ocena zawsze zależy od kontekstu.
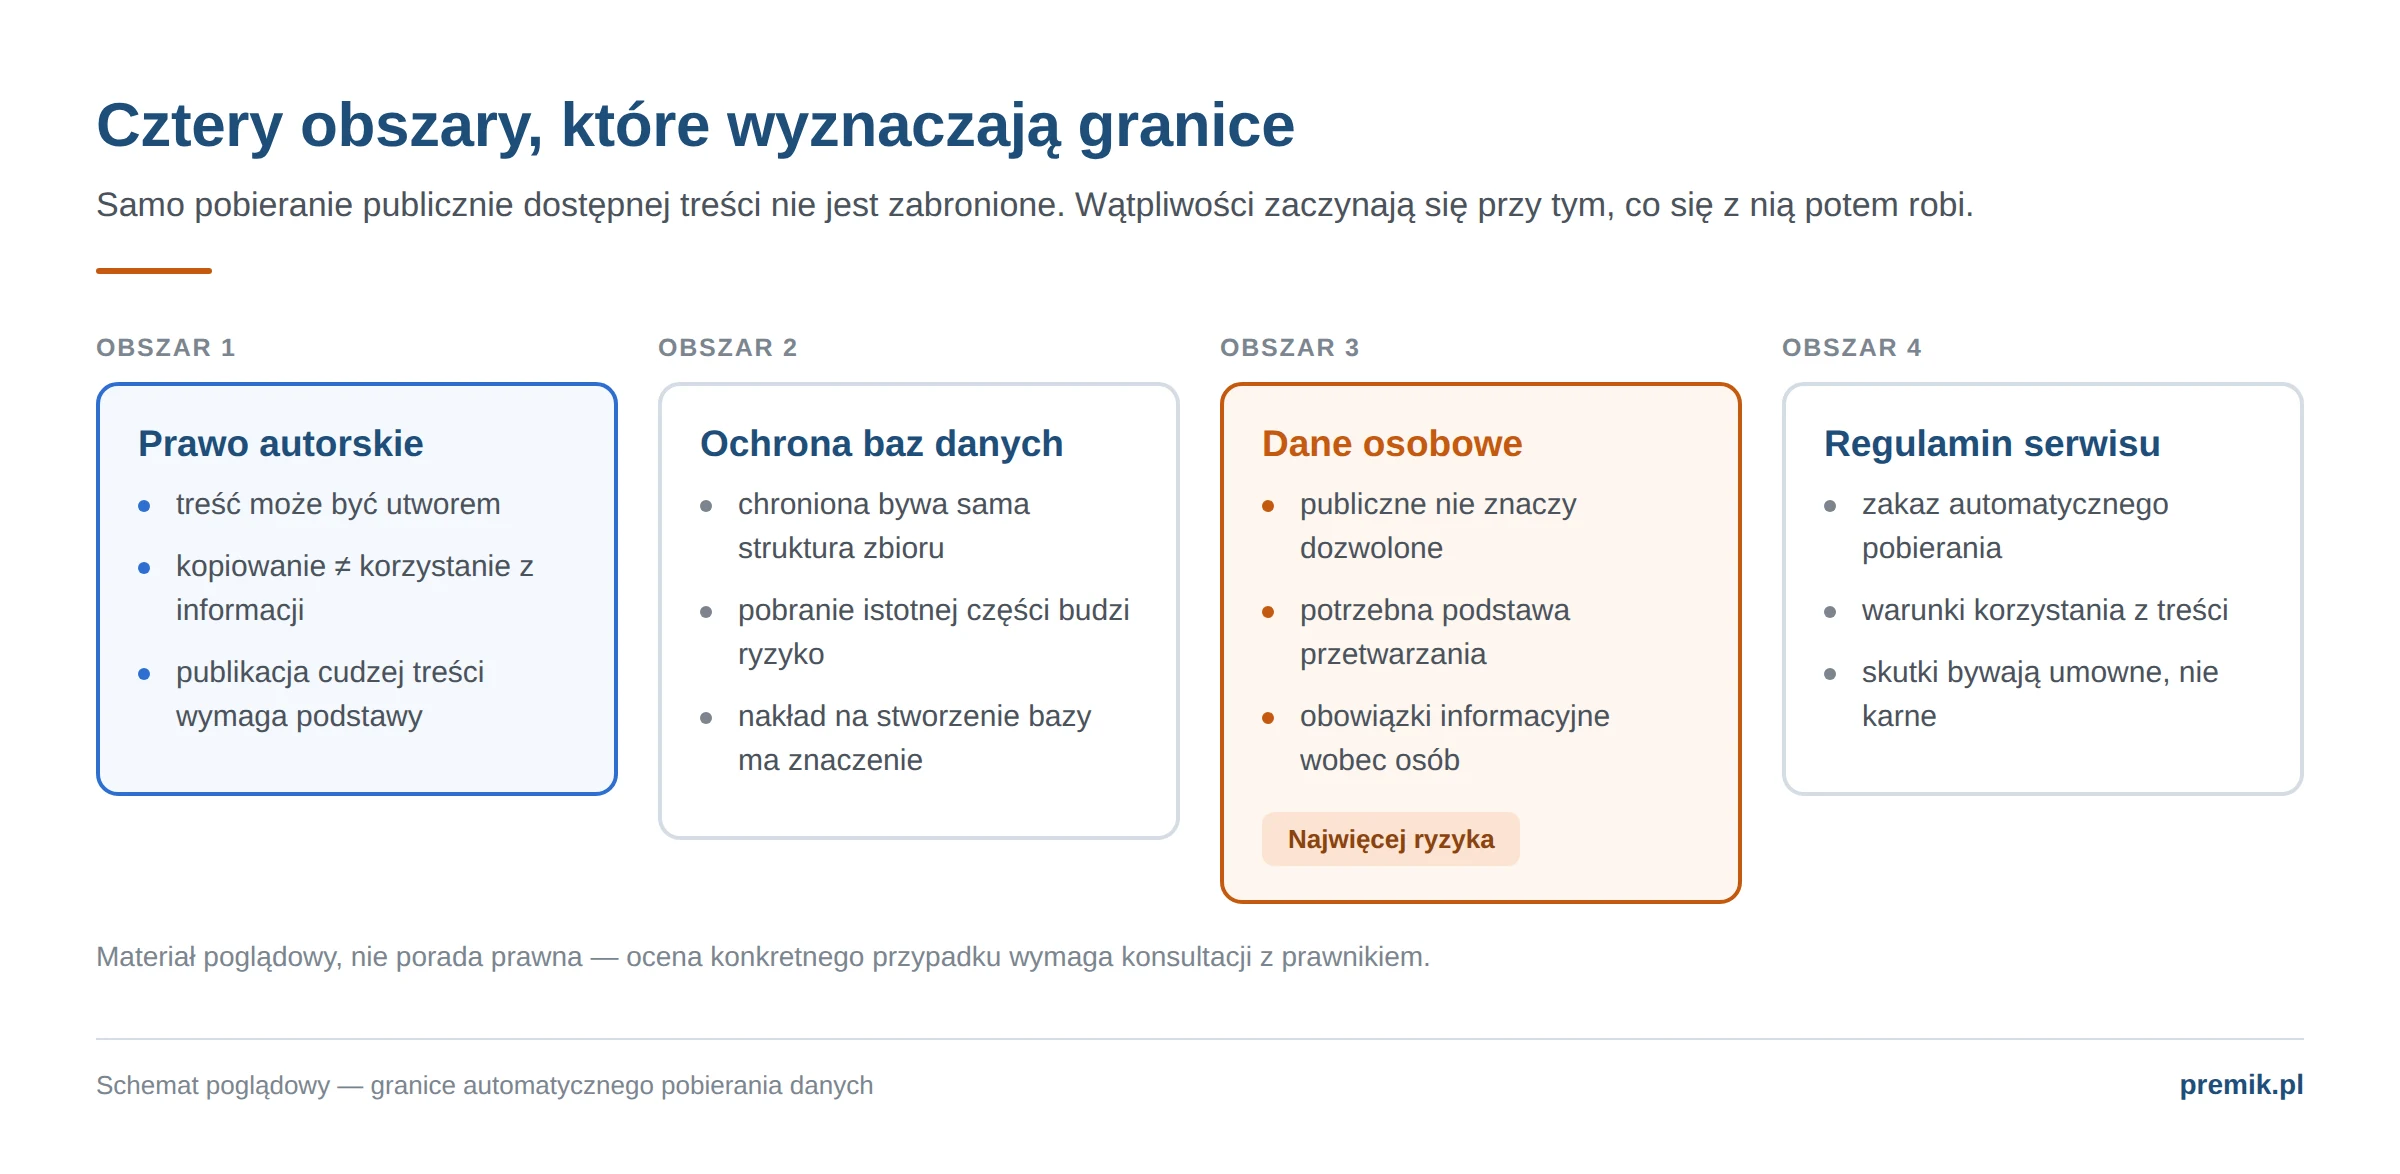
Cztery obszary, które wyznaczają granice
- Prawo autorskie – teksty, zdjęcia i opisy są utworami; ich kopiowanie i publikowanie wymaga podstawy prawnej.
- Ochrona baz danych – pobranie istotnej części zbioru bywa naruszeniem praw producenta bazy.
- Dane osobowe – imiona, adresy e-mail i profile osób podlegają RODO także wtedy, gdy są publicznie dostępne.
- Regulamin serwisu – zakaz automatycznego pobierania danych bywa wprost zapisany w warunkach korzystania.
| Obszar | Czego dotyczy | Typowe ryzyko |
|---|---|---|
| Prawo autorskie | teksty, zdjęcia, opisy produktów jako utwory | publikacja cudzych treści bez podstawy prawnej |
| Ochrona baz danych | istotna część uporządkowanego zbioru danych | pobranie i wykorzystanie całej bazy konkurencji |
| Dane osobowe (RODO) | imiona, adresy e-mail, profile osób – także publicznie dostępne | przetwarzanie bez podstawy prawnej i obowiązku informacyjnego |
| Regulamin serwisu | warunki korzystania, często zakaz automatycznego pobierania | blokada dostępu, roszczenia z tytułu naruszenia umowy |
Ocena dopuszczalności pobierania danych
Checklista: zasady odpowiedzialnego scrapingu
Prowadząc automatyzację analizy stron www, warto trzymać się pięciu zasad:
User-Agent: PremikBot/1.0 (+https://premik.pl/kontakt; kontakt@twojadomena.pl)
From: kontakt@twojadomena.pl

# W kodzie (przykład w Pythonie):
headers = {
    "User-Agent": "PremikBot/1.0 (+https://premik.pl/kontakt; kontakt@twojadomena.pl)",
    "From": "kontakt@twojadomena.pl",
}
# oraz odstęp między zapytaniami, np.:
time.sleep(2)Etyka ponad przepisami
Część praktyk jest dopuszczalna, a mimo to szkodliwa. Pobieranie danych w tempie spowalniającym cudzy serwis szkodzi jego klientom. Kopiowanie opisów produktów do własnego sklepu obniża wartość obu serwisów w oczach wyszukiwarki. Obchodzenie zabezpieczeń pokazuje wyraźnie, że właściciel nie życzy sobie automatycznego dostępu – i to jest sygnał, który warto uszanować niezależnie od interpretacji przepisów.
- Obchodzenie zabezpieczeń, CAPTCHA i blokad dostępu.
- Pobieranie danych osobowych bez ustalonej podstawy prawnej.
- Kopiowanie całych baz danych lub opisów produktów do własnego serwisu.
- Tempo zapytań, które realnie obciąża cudzy serwer.
Najczęściej zadawane pytania (FAQ)
Czy pobieranie publicznie dostępnych danych jest legalne?
Sam dostęp zwykle tak, ale sposób wykorzystania danych może naruszać prawo autorskie, ochronę baz danych lub przepisy o danych osobowych. To kwestia do oceny prawnej w konkretnym przypadku.
Czy robots.txt jest wiążący prawnie?
Nie jest umową, ale stanowi wyraźną deklarację właściciela serwisu i bywa brany pod uwagę przy ocenie działania w dobrej wierze.
Czy można pobierać ceny konkurencji?
Monitorowanie cen jest powszechną praktyką, ale warto ograniczyć zakres danych, respektować regulaminy i nie obciążać cudzych serwerów.
Co z danymi z serwisów społecznościowych?
To obszar szczególnie wrażliwy – dane dotyczą osób fizycznych, a regulaminy platform zwykle wprost zakazują automatycznego pobierania.
Napisz do mnie – zaprojektuję narzędzie respektujące limity serwisów i ograniczone do faktycznie potrzebnych danych.
Zamów narzędzie do analizy danych →Podsumowanie
Automatyczne pobieranie danych jest narzędziem neutralnym – o ocenie decyduje zakres, tempo i cel. Respektowanie robots.txt, ograniczanie obciążenia i unikanie danych osobowych to minimum, które chroni zarówno cudzy serwis, jak i własną firmę.
Bibliografia / Źródła zewnętrzne
- Imperva, „Bad Bot Report 2025” (dane za 2024 r.):https://www.imperva.com/blog/2025-imperva-bad-bot-report-how-ai-is-supercharging-the-bot-threat/